Фреймворк делегирования задач AI
Статья Google DeepMind «Intelligent AI Delegation» (Tomašev, Franklin, Osindero, февраль 2026) описывает механику передачи задач агентам: кто получает задачу и на каких правах, как проверяется результат, что происходит при сбое.
Статичная версия схемы (PNG)
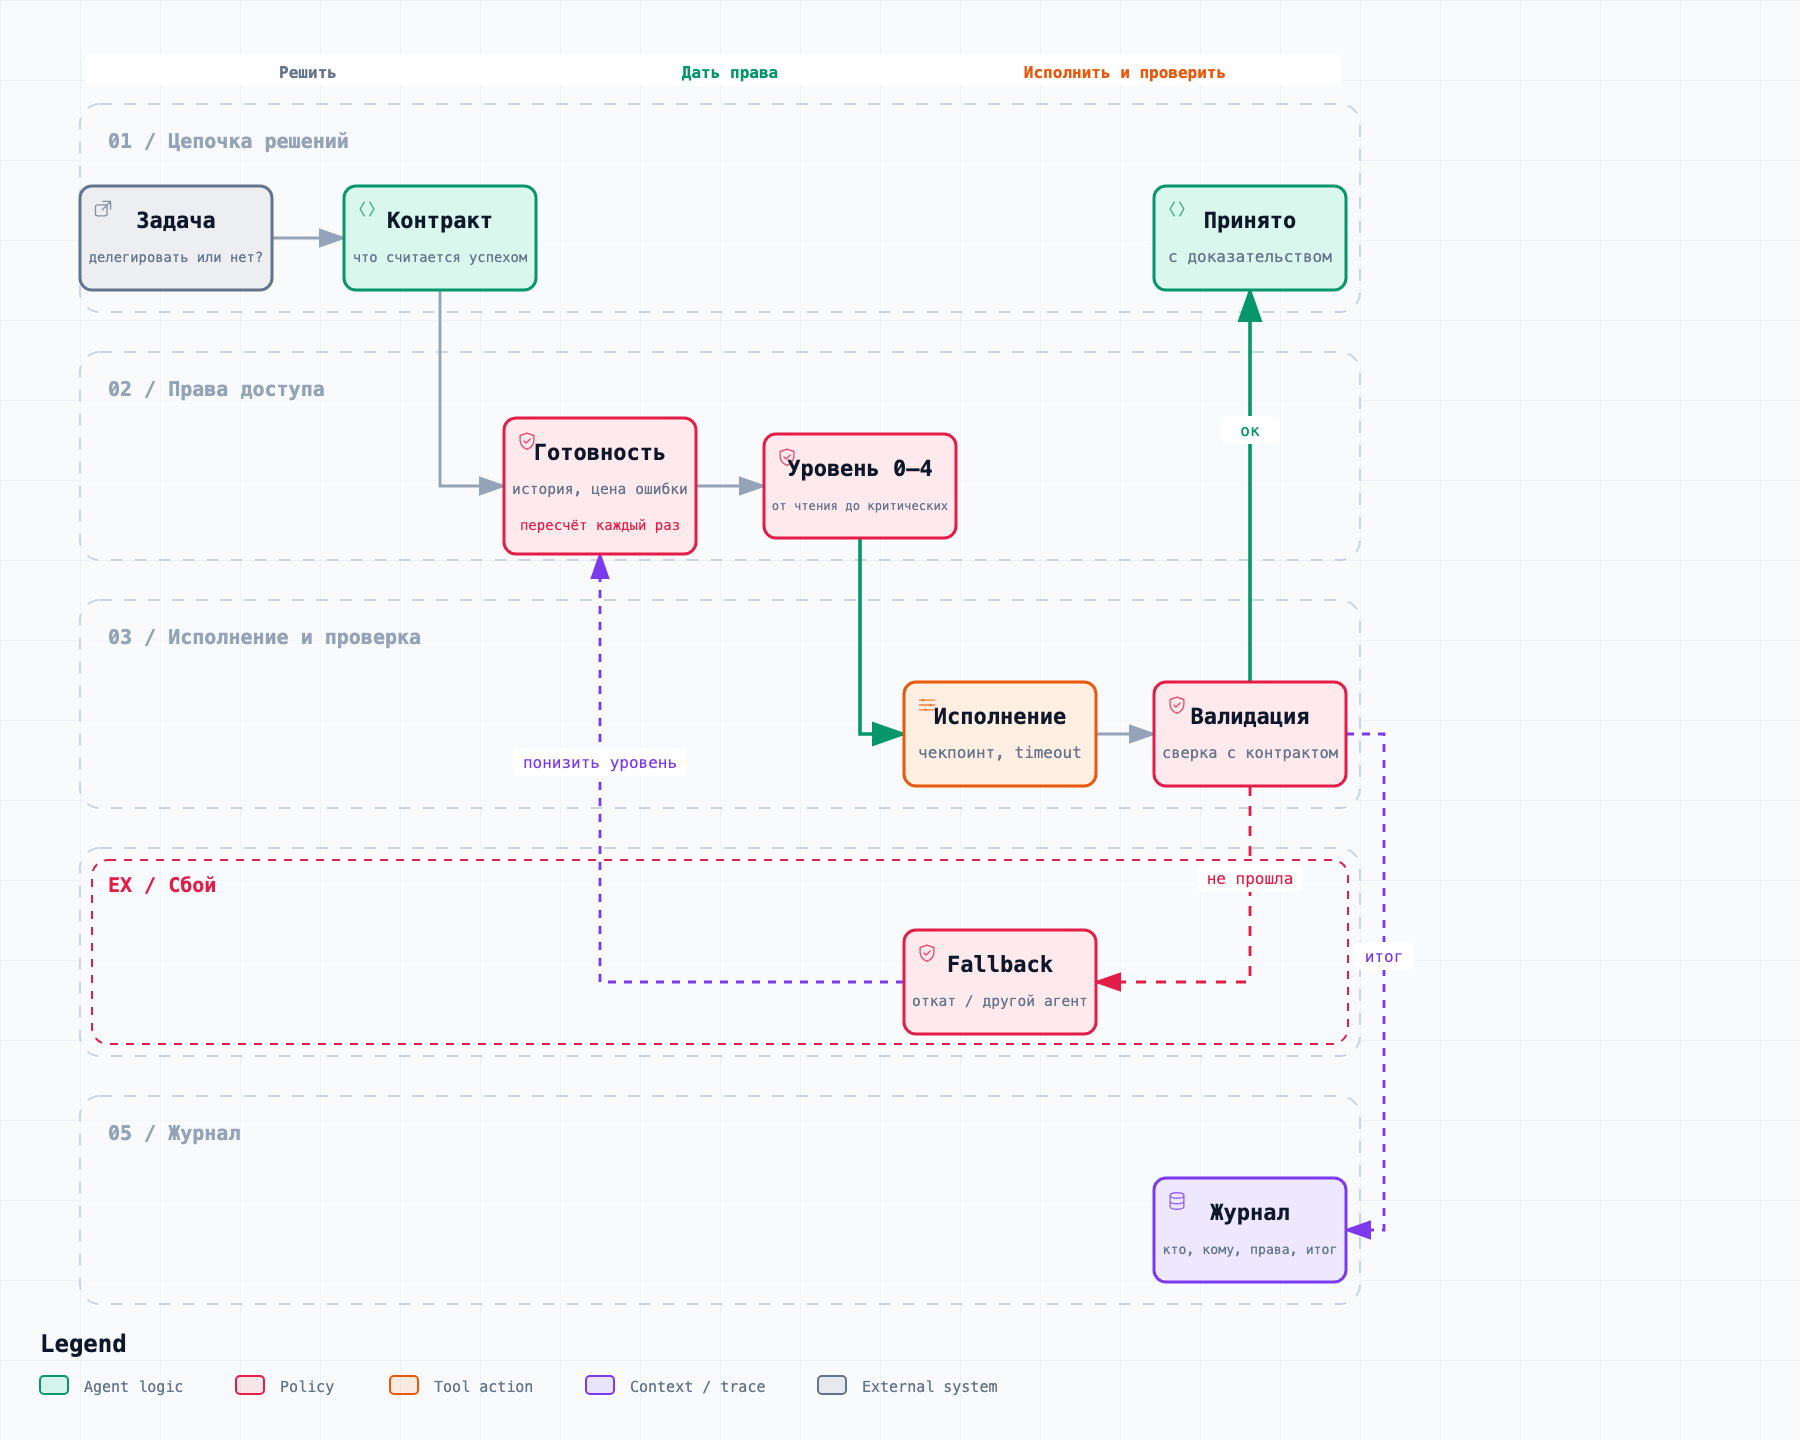
Схема целиком: контракт задаёт критерий успеха, права выдаются по уровню готовности агента, результат проверяется против контракта, при сбое включается fallback и уровень доступа понижается. Всё пишется в журнал.
Проблема: жёсткие системы ломаются
Большинство систем сейчас работает на if-then правилах. Пока сценарий предусмотрен, они предсказуемы. Первый непредусмотренный случай — и система либо падает, либо делает что-то опасное.
Пример: микросервис A ждёт ответа от B тридцать секунд, B сегодня медленный, правила на этот случай нет. Timeout, дальше не работает ничего.
В статье жёсткие правила предлагается заменить рынком, где агенты договариваются о задачах через контракты. Система сама решает, кому отдать задачу, на каких условиях и что делать при сбое.
Цепочка решений при делегировании
Отдавая задачу агенту, отвечаешь на четыре вопроса подряд:
- Нужно ли вообще передавать. Задача может быть тривиальной или слишком рискованной.
- Как сформулировать задачу, чтобы агент понял, что здесь считается успехом.
- Какие права дать: потратить $100, записать миллион строк в БД или только читать.
- Как проверить результат. На веру не берём, нужна механика валидации.
Ответы не фиксируются один раз. По ходу работы условия меняются: права пересматриваются, сложность растёт, появляется новая информация. Система должна уметь передать задачу другому агенту, откатиться на предыдущий этап или включить план B.
Доверие: over-delegating и under-delegating
Over-delegating — задачу отдают агенту, который к ней не готов. Ошибка в проде, потеря денег, утечка данных.
Under-delegating — всё делается руками, хотя агент справился бы быстрее и точнее. Потерянное время и сдвинутые сроки.
Фреймворк взвешивает сложность задачи, историческую точность агента на похожих задачах и стоимость ошибки. На этом решает: агент готов или нужна подстраховка.
Безопасность и прозрачность
Как доверять агенту, если не видно, что он делает? Вместо рейтингов вида ★★★★☆ в статье предлагаются проверяемые механизмы.
Криптографическая подпись результата: целостность можно проверить самому. Сертификаты вместо оценок: не «этот агент хороший», а «этот агент прошёл верификацию для финансовых операций». Zero-knowledge proofs (доказательство без раскрытия данных): система подтверждает корректность, не показывая приватные данные.
Разница примерно как между кредитным рейтингом и блокчейн-верификацией. Первый просит верить, вторая даёт проверить.
Проверка результатов
Выход агента тоже не принимается на веру. Для операций вроде «обновил конфиг в K8s» или «запустил миграцию БД» ошибка оставляет систему в broken state.
Система сверяет результат со сценарием успеха и учитывает заявленную уверенность агента («уверен на 95%» против «не знаю»). Если валидация не прошла, включается fallback.
В финтехе это жёстче всего: платёж не бывает «вроде обработан». Либо обработан с доказательством, либо откачен.
Передача между агентами
Задача может пройти через нескольких агентов: A парсит JSON, B валидирует, C пишет в БД. При каждой передаче система фиксирует три вещи. Кто отвечает за результат, если B потеряет часть данных. Какие права переходят вместе с задачей: может ли A заменить X на Y, может ли B откатить работу C. И кто вправе остановить цепочку посередине.
Логика та же, что в микросервисах: если сервис упал, кто-то должен инициировать откат. Разница только в том, что участники — агенты.
Иерархия доступа
Оговорка про источник: в самой статье нумерованных уровней нет. Раздел §4.7 Permission Handling описывает градиент полномочий без чисел; шкала 0–4 ниже, «откат в течение 5 секунд» и «согласие двух агентов» — интерпретация из разбора на vc.ru, которую я оставил, потому что она удобна как рабочая модель. Дословно из статьи — «zone of indifference» и «cognitive friction».
Уровень 0 — только чтение. Агент смотрит логи и метрики, ничего не меняет.
Уровень 1 — предложения. Готовит изменение и ждёт подтверждения.
Уровень 2 — исполнение с откатом. Запускает сам, откат доступен в течение 5 секунд.
Уровень 3 — автономная работа с логированием. Полные права, всё пишется в журнал.
Уровень 4 — критические операции: деньги, удаление, безвозвратные изменения. Нужно согласие двух агентов.
Права пересчитываются на каждой операции. Сломал что-то на уровне 3 — вернулся на уровень 2.
Как система оценивает готовность
Процент успеха на последних N операциях: если агент прав в 98% похожих задач, доверие растёт.
Стоимость ошибки: чтение конфига дёшево, удаление данных дорого, вес у них разный.
Заявленная уверенность агента: «уверен на 70%» понижает уровень доступа.
Консистентность по времени: если в пиковые часы агент ошибается чаще, его ограничивают по времени работы.
Что может сломаться
Каскадный отказ. A передал задачу B, B передал C, C упал, цепочка рушится. Лечится контрольной точкой у каждого агента: можно вернуться на несколько шагов назад.
Злонамеренный (византийский) отказ. Агент сломан и отдаёт другим заведомо неверные данные, а не просто ошибается сам. Лечится согласием большинства агентов.
Исчерпание ресурсов. Агент застрял на задаче и выедает ресурсы. Лечится жёстким timeout и автоматическим завершением при превышении лимитов.
Дрейф прав доступа. Агенту выдали права, он ими не пользовался, про них забыли — а потом он их неожиданно применил. Лечится регулярным переподтверждением прав, например раз в неделю.
Видимость системы и мониторинг
Если не видно, что делает AI, системой не управляют.
Логируется весь жизненный цикл задачи: кто отдал, кому, с какими правами; промежуточные этапы, если задача разбита на подзадачи; финальный результат и его валидация; время выполнения и потраченные ресурсы.
Уверенность выводится графиком: «был уверен на 90%, потом сомнения упали до 40%» — это сигнал проблемы.
Отклонения ловятся сравнением текущего поведения агента с историческим: стал ошибаться чаще или работать медленнее — поднимается алерт.
Каждое решение агента записано и доступно для проверки, для аудита и разбора инцидентов.
Где это работает на практике
DevOps и инфраструктура
Агент автоматизирует развёртывание. Начинаем с уровня 1 (предложения), поднимаемся до уровня 2 (исполнение с откатом за 5 секунд), затем до уровня 3. И то только в staging: в production нужно человеческое подтверждение. Отслеживаем уверенность и отклонения, начал ошибаться чаще — урезаем права.
Финансовые пайплайны данных
Агент обрабатывает денежные операции. Удалить запись он не может, только пометить как «в обработке». Валидация на каждом шаге, при ошибке откат и алерт. Многоагентный сценарий: парсинг на уровне 1, проверка на уровне 2, сохранение на уровне 3 и только при согласии двоих.
Безопасность и аудит логов
Агент мониторит логи и ищет аномалии, по умолчанию на уровне 0. Нашёл подозрительную активность — передаёт выше и привлекает второго агента для независимой проверки. Всё пишется в журнал.
Оркестрация нескольких агентов
Несколько агентов работают над одной задачей. Фреймворк нужен, чтобы они не мешали друг другу и честно откатывались при сбое. Каскадный отказ не должен положить всю систему, поэтому каждый агент хранит контрольную точку.
Фреймворк Google DeepMind описывает не «как я дал команду в Slack», а как строится распределённая система, где люди и агенты работают вместе, никто не может всё сломать, и по журналу всегда видно, кто что сделал и почему.
Источник: arxiv.org/abs/2602.11865 — Google DeepMind, «Intelligent AI Delegation». Разбор на vc.ru.
Дисклеймер / Disclaimer: material is published for informational and research purposes. Полный отказ от ответственности / Full disclaimer.